
항목
RISC
reduced instruction set computing
전자 공학 및 컴퓨터 과학에서 축소 명령어 집합 컴퓨터(reduced instruction set computer, RISC, "리스크"라고 발음)는 컴퓨터에게 부여되는 개별 명령어를 단순화하여 작업을 수행하도록 설계된 컴퓨터 구조이다. 복잡 명령어 집합 컴퓨터(CISC)에 주어지는 명령어와 비교할 때, RISC 컴퓨터…
항목
reduced instruction set computing
전자 공학 및 컴퓨터 과학에서 축소 명령어 집합 컴퓨터(reduced instruction set computer, RISC, "리스크"라고 발음)는 컴퓨터에게 부여되는 개별 명령어를 단순화하여 작업을 수행하도록 설계된 컴퓨터 구조이다. 복잡 명령어 집합 컴퓨터(CISC)에 주어지는 명령어와 비교할 때, RISC 컴퓨터…
이 항목이 포함된 사건 파일에서 정보와 관계를 함께 살펴보세요.
이 항목이 포함된 사건 파일이 아직 없습니다.
이 항목으로 조사 시작하기전자 공학 및 컴퓨터 과학에서 축소 명령어 집합 컴퓨터(reduced instruction set computer, RISC, "리스크"라고 발음)는 컴퓨터에게 부여되는 개별 명령어를 단순화하여 작업을 수행하도록 설계된 컴퓨터 구조이다. 복잡 명령어 집합 컴퓨터(CISC)에 주어지는 명령어와 비교할 때, RISC 컴퓨터는 개별 명령어가 더 단순한 연산을 수행하기 때문에 작업을 완료하는 데 더 많은 기계어 코드가 필요할 수 있다.
전자 공학 및 컴퓨터 과학에서 축소 명령어 집합 컴퓨터(reduced instruction set computer, RISC, "리스크"라고 발음)는 컴퓨터에게 부여되는 개별 명령어를 단순화하여 작업을 수행하도록 설계된 컴퓨터 구조이다. 복잡 명령어 집합 컴퓨터(CISC)에 주어지는 명령어와 비교할 때, RISC 컴퓨터는 개별 명령어가 더 단순한 연산을 수행하기 때문에 작업을 완료하는 데 더 많은 기계어 코드가 필요할 수 있다. 그 목적은 개별 명령어의 속도를 높임으로써 더 많은 명령어를 처리해야 하는 필요성을 상쇄하는 것이며, 특히 단순한 명령어에서 구현하기 더 쉬운 명령어 파이프라인을 통해 이를 달성한다.
RISC 컴퓨터의 핵심적인 운영 개념은 각 명령어가 오직 하나의 기능(예: 메모리에서 레지스터로 값을 복사)만을 수행한다는 것이다. RISC 컴퓨터는 대개 다수(16개 또는 32개)의 고속 범용 레지스터를 갖춘 로드-스토어 아키텍처를 사용한다. 이 구조에서 산술 연산 및 테스트를 수행하는 명령어는 오직 레지스터 상에서만 작동하며, 컴퓨터의 주 메모리 데이터에 접근하는 명령어는 메모리에서 레지스터로 데이터를 로드하거나 레지스터에서 메모리로 데이터를 저장하는 역할만 수행한다. CPU 설계 덕분에 RISC 컴퓨터는 소수의 단순한 주소 지정 방식과 예측 가능한 명령어 실행 시간을 가지며, 이는 시스템 전체의 설계를 단순화한다.
RISC 컴퓨터 구조의 개념적 발전은 1970년대 후반 IBM 801 프로젝트와 함께 시작되었으나, 즉시 실용화되지는 않았다. 캘리포니아의 설계자들은 801의 개념을 이어받아 두 가지 중대한 프로젝트인 스탠퍼드의 MIPS와 버클리의 버클리 RISC를 시작했다. 이들은 1980년대에 MIPS 및 SPARC 시스템으로 상용화되었다. IBM은 결과적으로 801 개념에 대한 후속 연구를 바탕으로 IBM POWER 아키텍처, 파워PC, Power ISA 등의 RISC 설계를 생산했다. 프로젝트가 성숙해짐에 따라 1980년대 중후반과 1990년대 초반에 ARM 아키텍처, PA-RISC, 알파와 같은 유사한 설계가 다수 등장했다. 이러한 중앙 처리 장치들은 유닉스 워크스테이션과 레이저 프린터, 라우터, 그리고 이와 유사한 제품들에 들어가는 임베디드 프로세서의 상업적 유용성을 높였다.
미니컴퓨터 시장에서 셀러리티 컴퓨팅, 피라미드 테크놀로지, 릿지 컴퓨터스 등의 회사들이 1980년대 초반에 RISC 또는 RISC와 유사한 원리에 따라 설계된 시스템을 제공하기 시작했다. 이러한 초기 설계 중 RISC 마이크로프로세서를 직접 사용한 경우는 드물었다.
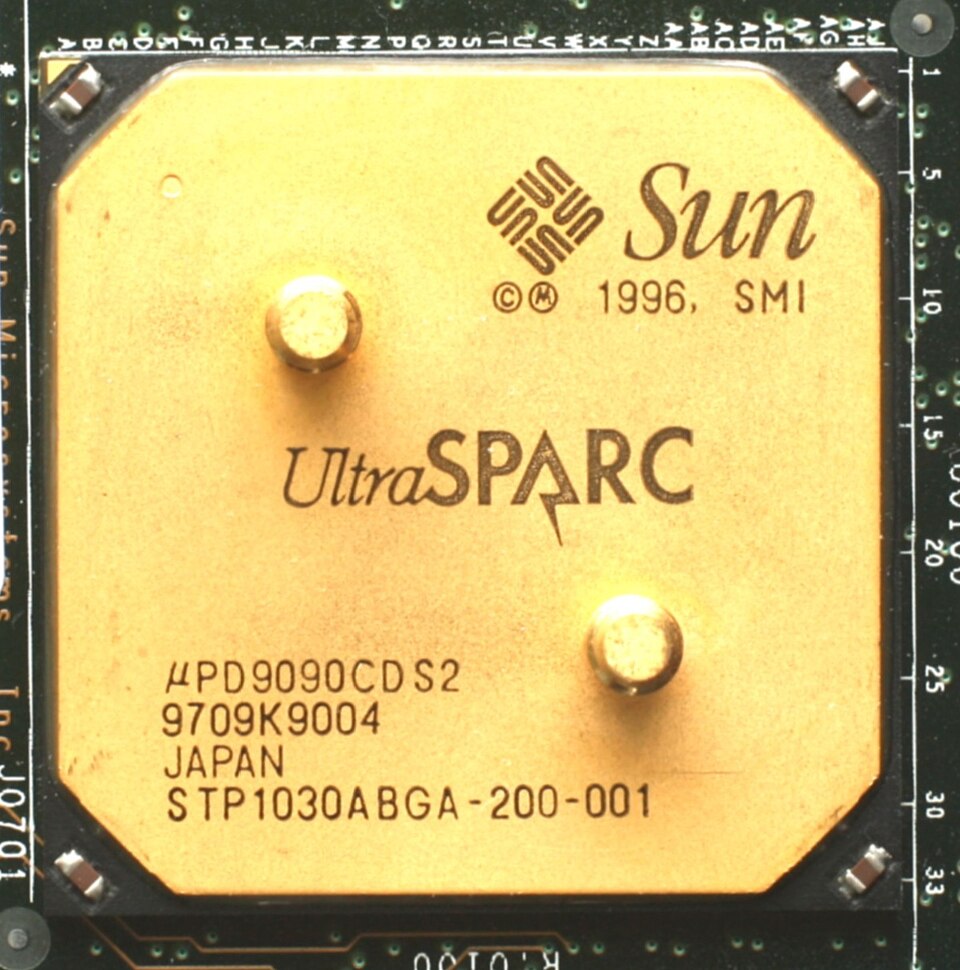
RISC 프로세서 설계의 종류에는 ARC 프로세서, DEC 알파, AMD Am29000, ARM 아키텍처, 아트멜 AVR, 블랙핀, 인텔 i860, 인텔 i960, 룽아키텍처(LoongArch), 모토로라 88000, MIPS 아키텍처, PA-RISC, Power ISA, RISC-V, 슈퍼H, SPARC 등이 있다. RISC 프로세서는 후가쿠와 같은 슈퍼컴퓨터에서도 사용된다.
1960년대로 거슬러 올라가는 여러 시스템이 로드-스토어 접근 방식을 부분적으로 사용했다는 점에서 최초의 RISC 아키텍처로 인정받아 왔다. RISC라는 용어는 버클리 RISC 프로젝트의 데이비드 패터슨에 의해 만들어졌으나, 그 이전에도 다소 유사한 개념들이 등장한 바 있다.
1964년 시모어 크레이가 설계한 CDC 6600은 오직 두 가지 주소 지정 방식(레지스터+레지스터, 레지스터+즉시 상수)과 74개의 운영 코드를 가진 로드-스토어 아키텍처를 사용했으며, 기본 클럭 사이클은 메모리 접근 시간보다 10배 빨랐다. CDC 6600의 최적화된 로드-스토어 아키텍처 덕분에 잭 동가라는 이를 현대 RISC 시스템의 선구자로 간주할 수 있다고 말했으나, 현대적인 RISC 시스템의 발전을 위해서는 다른 여러 기술적 장벽을 극복해야 했다.
마이클 J. 플린(Michael J. Flynn)은 최초의 RISC 시스템을 1975년 존 코크에 의해 시작되어 1980년에 완성된 IBM 801 설계로 본다. 801은 디지털 전화 교환기의 기초로 사용할 24비트 고속 프로세서를 구축하려는 노력에서 발전했다. 시간당 100만 건의 통화(초당 300건)를 교환한다는 목표를 달성하기 위해, 그들은 CPU가 약 1,200만 초당 명령 수(MIPS)의 성능을 내야 한다고 계산했다. 이는 당시 그들의 가장 빠른 메인프레임 기계였던 370/168이 3.5 MIPS의 성능을 냈던 것과 비교된다.
이 설계는 IBM이 고객들로부터 수집한 방대한 통계 자료에 대한 연구를 바탕으로 했다. 연구 결과, 고성능 설정의 코드는 프로세서 레지스터를 집중적으로 사용하며 자주 레지스터 부족 현상을 겪는다는 것이 입증되었다. 이는 레지스터를 추가하면 성능이 향상될 것임을 시사했다. 또한, 그들은 컴파일러가 사용 가능한 대다수의 명령어, 특히 직교 주소 지정 방식을 무시한다는 사실을 발견했다. 대신 컴파일러는 주어진 명령어 중 가장 빠른 버전을 선택한 다음 이를 사용하여 작은 루틴을 구성했다. 이는 결과 코드에 영향을 주지 않고 대다수의 명령어를 제거할 수 있음을 시사했다. 이 두 가지 결론은 서로 조화를 이루었다. 명령어를 제거하면 명령어 오프코드를 짧게 만들 수 있고, 명령어 워드에서 남는 비트를 더 큰 레지스터 세트 중 하나를 선택하는 데 사용할 수 있기 때문이었다.
전화 교환기 프로그램은 1975년에 취소되었으나, 그때 이미 팀은 동일한 설계가 거의 모든 코드를 실행할 때 상당한 성능 향상을 제공한다는 점을 입증했다. 시뮬레이션에서 그들은 메모리에서 직접 작업하는 대신 레지스터를 사용하도록 튜닝된 컴파일러가 기존 설계보다 약 3배 빠르게 코드를 실행할 것임을 보여주었다. 다소 놀랍게도, 동일한 코드가 기존 기계에서도 개선된 레지스터 사용 덕분에 약 50% 더 빠르게 실행되었다. 실제로 그들의 실험적인 PL/8 컴파일러(PL/I의 축소 버전)는 기존 메인프레임에서 훨씬 더 빠르게 실행되는 코드를 일관되게 생성해냈다.
801의 32비트 버전은 결과적으로 1981년 'Research OPD [Office Products Division] Micro Processor'의 약자인 IBM ROMP라는 단일 칩 형태로 생산되었다. 이 CPU는 "미니" 작업을 위해 설계되었으며, 이후 IBM 컴퓨터의 주변 장치 인터페이스와 채널 컨트롤러에서 사용되었다. 또한 1986년 IBM RT PC의 CPU로 사용되었으나 이는 상업적 실패로 끝났다. 801이 원래 형태 그대로 널리 사용되지는 않았으나, 이는 IBM 내부의 여러 연구 프로젝트에 영감을 주었고 결과적으로 IBM POWER 아키텍처로 이어지게 되었다.
1970년대 후반에 이르러 801은 업계에 잘 알려지게 되었다. 이는 더 복잡한 칩을 시장에 내놓을 수 있게 해준 새로운 제조 기술의 등장과 시기적으로 일치했다. 1976년의 자일로그 Z80은 8,000개의 트랜지스터를 가졌던 반면, 1979년의 모토로라 68000(68k)은 68,000개를 가졌다. 이러한 새로운 설계들은 일반적으로 새로 확보된 복잡성을 사용하여 명령어 집합을 확장함으로써 더 직교적으로 만들고자 했다. 68k와 같은 대부분의 설계는 이를 위해 마이크로코드를 사용하여 명령어를 읽고 이를 더 단순한 내부 명령어 시퀀스로 다시 구현했다. 68k의 경우 트랜지스터의 무려 1⁄3이 이 마이크로코딩을 위해 사용되었다.
1979년, 데이비드 패터슨은 DEC의 서부 해안 팀이 VAX 마이크로코드를 개선하는 것을 돕기 위해 캘리포니아 대학교 버클리에서 사바티칼을 떠나 파견되었다. 패터슨은 코딩 과정의 복잡성에 충격을 받았고 이것이 감당하기 어려운 수준이라고 결론지었다. 그는 처음에 마이크로코딩을 개선하는 방법에 관한 논문을 썼으나, 나중에 생각을 바꾸어 마이크로코드 자체가 문제라고 결정했다. DARPA VLSI 프로그램의 지원을 받아 패터슨은 버클리 RISC 연구를 시작했다. 오늘날에는 거의 알려지지 않은 이 프로그램은 칩 설계, 제조, 심지어 컴퓨터 그래픽 분야에서 엄청난 발전을 이끌어냈다. 그들의 BSD 변종에 포함된 다양한 프로그램들을 검토한 결과, 버클리 팀은 IBM이 발견했던 것처럼 대부분의 프로그램이 68k에 있는 방대한 종류의 명령어를 전혀 사용하지 않는다는 것을 발견했다.
패터슨의 초기 작업은 전통적인 "많을수록 좋다"는 접근 방식의 중요한 문제를 지적했다. 전체 성능에 결정적인 명령어들조차 마이크로코드를 거치는 과정 때문에 지연되고 있었다. 마이크로코드를 제거한다면 프로그램은 더 빠르게 실행될 것이다. 그리고 마이크로코드가 궁극적으로 복잡한 명령어를 단계별로 쪼개는 역할을 한다면, 컴파일러가 대신 그렇게 하지 못할 이유가 없었다. 이러한 연구들은 다른 변화가 없더라도 트랜지스터를 1⁄3 적게 사용하면서도 더 빨리 작동하는 칩을 만들 수 있음을 시사했다. 원래의 RISC-I 논문에서 그들은 다음과 같이 언급했다.
이러한 추가적인 해석 단계를 건너뛰는 것은 칩 크기를 줄이면서도 성능을 향상시키는 것으로 보인다.
또한 특정 아키텍처의 마이크로코드 구현에서는 복잡한 연산이 동일한 일을 수행하는 단순한 연산 시퀀스보다 느린 경향이 있다는 사실이 발견되었다. 이는 많은 설계가 서둘러 이루어져 모든 명령어를 최적화하거나 튜닝할 시간이 부족했다는 사실의 결과이기도 했다. 가장 자주 사용되는 명령어들만 최적화되었으며, 그러한 명령어들의 시퀀스가 그 시퀀스와 동일한 연산을 수행하는 덜 최적화된 명령어보다 더 빠를 수 있었다. 악명 높은 예 중 하나가 VAX의 INDEX 명령어였다.
버클리의 연구는 또한 몇 가지 추가적인 점들을 밝혀냈다. 그중 하나는 프로그램이 서브루틴 호출 및 반환을 수행하는 데 상당한 시간을 보낸다는 사실이었으며, 이러한 호출 속도를 높임으로써 전체 성능을 향상시킬 수 있는 잠재력이 있어 보였다. 이로 인해 버클리 설계는 약간의 복잡성을 대가로 서브루틴 성능을 크게 향상시킬 수 있는 레지스터 윈도라는 방법을 선택하게 되었다. 그들은 또한 대다수의 수학 명령어가 단순한 할당이라는 점을 알아차렸다. 그중 단 1⁄3만이 실제로 덧셈이나 뺄셈 같은 연산을 수행했다. 그러나 그러한 연산이 발생할 때 그것들은 느린 경향이 있었다. 이는 칩의 대부분이 제어와 마이크로코드에 할당되었던 이전 설계들과 달리, 기저의 산술 데이터 유닛에 훨씬 더 많은 중점을 두게 만들었다.
그 결과 탄생한 버클리 RISC는 파이프라이닝과 공격적인 레지스터 윈도잉 사용을 통해 성능을 확보하는 데 기반을 두었다. 전통적인 CPU에서는 레지스터 수가 적고 프로그램이 언제든 어떤 레지스터든 사용할 수 있다. 레지스터 윈도를 가진 CPU에는 예를 들어 128개와 같이 매우 많은 수의 레지스터가 있으나, 프로그램은 한 번에 예를 들어 8개와 같이 적은 수만 사용할 수 있다. 각 프로시저당 8개의 레지스터로 스스로를 제한하는 프로그램은 매우 빠른 절차 호출을 수행할 수 있다. 호출은 단지 윈도를 해당 프로시저가 사용하는 8개의 레지스터 세트로 8단계 "아래로" 이동시키고, 반환 시에는 윈도를 다시 되돌리기만 하면 된다. 버클리 RISC 프로젝트는 1982년 RISC-I 프로세서를 내놓았다. 당시의 새로운 CISC 설계들이 평균 약 100,000개의 트랜지스터를 사용했던 것에 비해 단 44,420개로 구성된 RISC-I은 32개의 명령어만을 가졌음에도 VAX보다 높은 추정 성능을 기록하며 다른 어떤 단일 칩 설계보다 뛰어난 성능을 보였다. 그들은 1983년에 40,760개의 트랜지스터와 39개의 명령어를 가진 RISC-II로 이를 따랐으며, 이는 RISC-I보다 3배 이상 빠르게 작동했다.
RISC 프로젝트가 실리콘 밸리에 알려지기 시작하면서, 1981년 스탠퍼드 대학교에서도 유사한 프로젝트가 시작되었다. 이 MIPS 프로젝트는 존 L. 헤네시의 대학원 과정에서 발전하여 1983년에 작동하는 시스템을 생산했고, 1984년에는 간단한 프로그램을 실행할 수 있었다. MIPS 방식은 공격적인 클럭 사이클과 파이프라인의 사용을 강조하여 파이프라인이 가능한 한 "가득 차서" 돌아갈 수 있도록 하는 데 주력했다. MIPS 시스템은 MIPS-X로 이어졌으며, 1984년 헤네시와 그의 동료들은 해당 설계를 상용화하기 위해
출처: 축소 명령어 집합 컴퓨터 (CC BY-SA)
확인된 구조화 정보, 사용자 의견, AI가 찾은 관계를 구분해 표시해요.
아직 댓글이 없어요. 먼저 한마디 남겨 보세요.